
Behandel je content als een pot pindakaas: 5 stappen naar meer grip

Producten stoppen we niet zomaar ergens in een magazijn om vervolgens te hopen dat iemand ze terugvindt. Bij content doen we dat gek genoeg wel. Terwijl hergebruik, automatisering en AI een stuk eenvoudiger worden zodra je je contentvoorraad net zo serieus organiseert als je assortiment.
We moeten onze content hetzelfde behandelen als onze producten.
Die gedachte gebruik ik al jaren om contentmanagement uit te leggen. En een supermarkt werkt daarvoor als metafoor nog altijd het beste:
Stel je een winkel voor die met producten omgaat zoals veel organisaties met hun content omgaan. Nieuwe artikelen komen binnen en worden ergens neergezet: soms in het magazijn, soms direct in de winkel, soms in de opslag van een ander bedrijf. Er zijn geen vaste artikelnummers en niemand houdt bij welke verpakking de nieuwste is. Productcategorieën heten bij elke vestiging anders. Van sommige artikelen liggen vijf exemplaren op verschillende plekken, terwijl niemand zeker weet welke nog verkocht mogen worden, want er staat geen houdbaarheidsdatum op.
Vraagt een klant dan of je die ene pindakaas nog hebt, dan zegt de winkelmedewerker: “Momentje, ik bel even Karin van het hoofdkantoor. Zij weet waar die staat.”
Geen enkele retailer zou zo willen werken. Bij content vinden we het verrassend normaal. Websiteteksten in een CMS, afbeeldingen in een DAM, campagnemateriaal in SharePoint, video’s ergens bij een agency, en de nieuwste versie van een document in de mailbox van een collega. Ondertussen blijven we nieuwe content produceren.
Het probleem is dus zelden dat organisaties te weinig content hebben. Meestal hebben ze te weinig grip op de content die er al is.
Van productvoorraad naar contentvoorraad
Bij producten vinden we structuur vanzelfsprekend. Een product heeft een uniek artikelnummer, een naam, een merk, een categorie, kenmerken, een prijs, een voorraadstatus, een leverancier en vaak een houdbaarheidsdatum. Al die informatie helpt om het product te vinden, verkopen, vervoeren, analyseren en beheren.
Een pak yoghurt is voor het systeem daarom niet zomaar een pak yoghurt. Het is een herkenbaar dataobject met eigenschappen en relaties. Precies daarom kunnen retailers miljoenen artikelen door distributiecentra, winkels, websites en apps laten bewegen zonder dat iemand telkens handmatig hoeft uit te leggen wat elk artikel is. In de tien jaar dat ik bij Albert Heijn aan content en contentmigraties werkte, viel me dat contrast steeds op: de productkant was tot in detail gestructureerd, de contentkant leunde op mensen die toevallig de juiste informatie hadden.
Neem bijvoorbeeld een afbeelding met de bestandsnaam campagne_zomer_final_v3_nieuw.jpg.
Waar gaat het over, voor welke campagne is het gemaakt, op welke kanalen mag het gebruikt worden, welke producten staan erop, tot wanneer gelden de gebruiksrechten, is dit werkelijk de laatste versie en wie past het aan als er iets moet veranderen? Het bestand zelf vertelt het systeem daar vrijwel niets over. Daar begint contentchaos.
Content is voorraad, geen eindeloze stroom van creatie
We praten veel over contentproductie. Wat posten we volgende week, welke blogs moeten nog geschreven worden, welke campagneassets zijn nodig, welke video gaan we maken. Dat is logisch, want productie is zichtbaar werk.
Een retailer kijkt niet alleen naar wat er morgen uit de fabriek komt. Die wil ook weten wat er al ligt, waar het ligt, wat goed verkoopt, wat verouderd is en wat opnieuw gebruikt kan worden. Die vragen zouden we veel vaker over content moeten stellen, want hoe groter je contentvoorraad wordt, hoe duurder slecht beheer van content wordt.
De rekening komt in herkenbare vormen. Mensen kunnen bestaande content niet vinden en maken iets opnieuw. Teksten worden gekopieerd naar meerdere systemen en lopen daarna niet meer synchroon. Verouderde informatie blijft online staan. Campagneassets verdwijnen na gebruik in een digitale rommelkast. Iedere nieuwe tool krijgt opnieuw een kopie van dezelfde content. Voor je het weet heb je geen voorraad meer, maar vijf stoffige magazijnen met gedeeltelijk dezelfde verouderde spullen.
Een nieuw CMS, DAM of AI-tool lost dat niet op. Je hebt dan vooral een mooier magazijn gekregen, met de dozen nog steeds door elkaar. Hoe krijg je daar meer grip op?
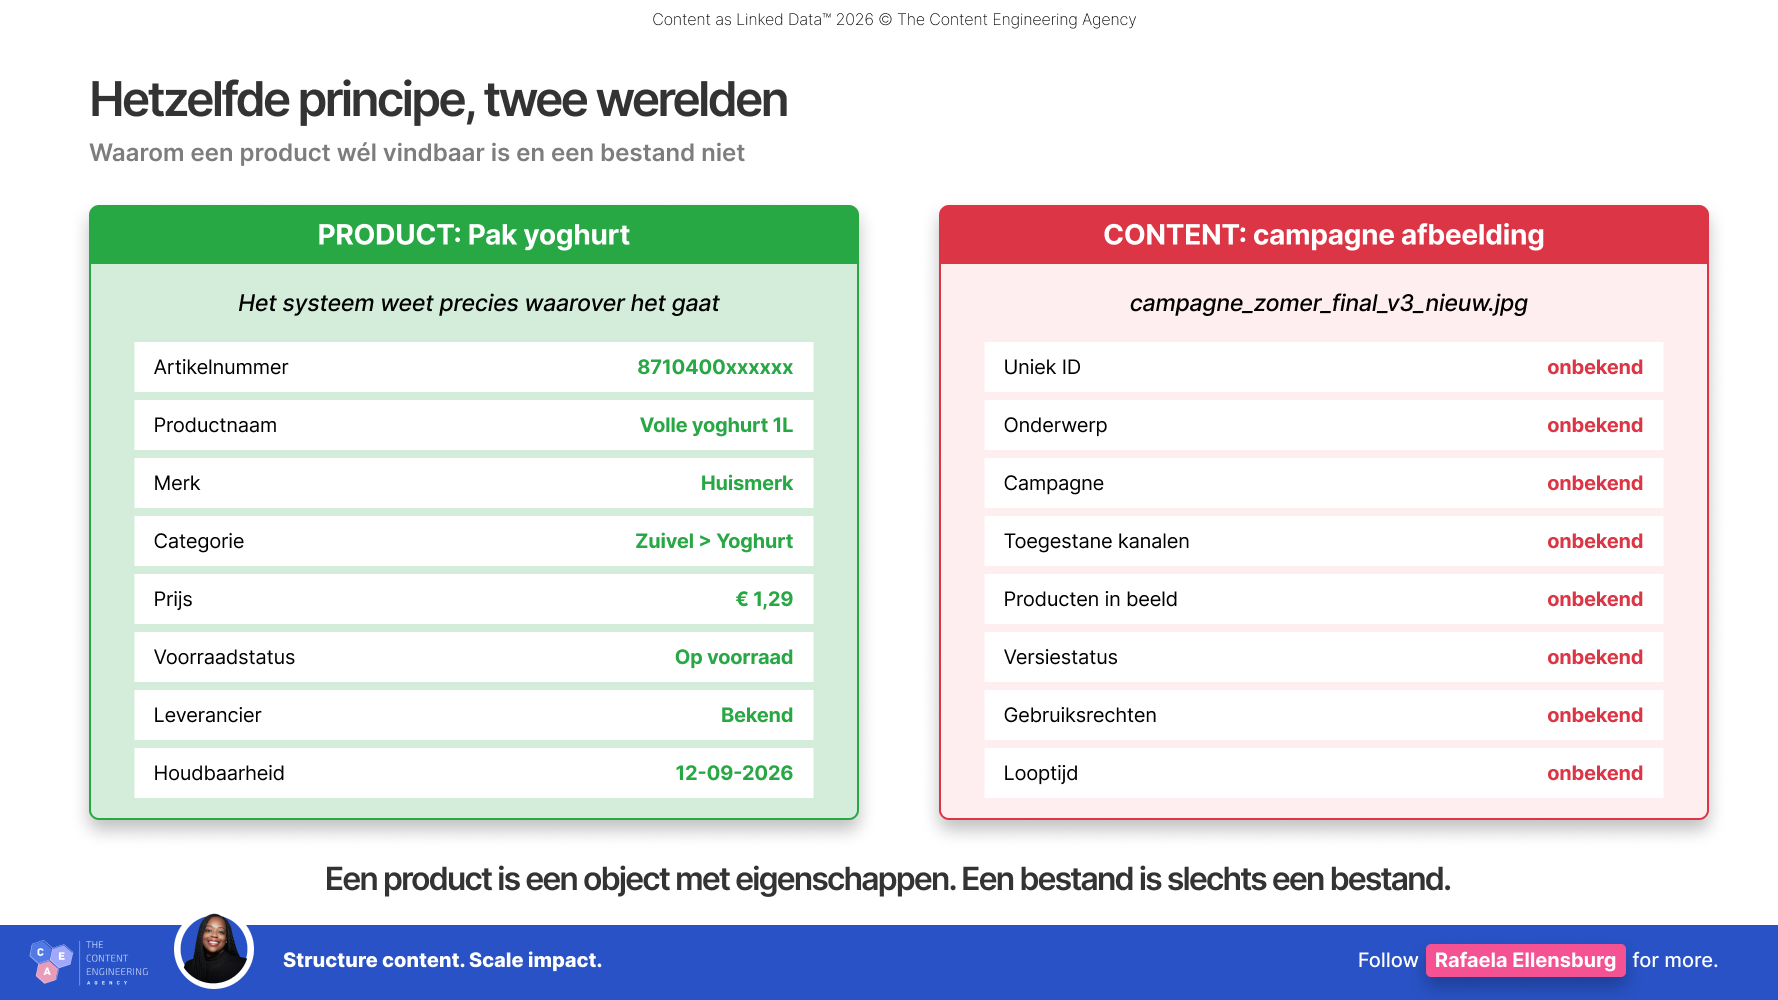
Producten behandelen we als objecten met eigenschappen. Bij content ontbreekt die structuur vaak nog. Beeld: The Content Engineering Agency.
Stap 1. Weet wat je op voorraad hebt
Een retailer begint niet met distributie voordat duidelijk is welke producten er zijn. Begin bij content daarom met een eenvoudige inventarisatie (en breng vooral niet meteen tien jaar aan content in kaart!).
Kies één herkenbaar, veelgebruikt, strategisch waardevol contenttype: productteksten, campagnecontent, fotografie, blogs, FAQ’s, social media assets of instructievideo’s. Stel daarover één vraag: wat hebben we eigenlijk allemaal?
Je vindt vrijwel zeker duplicaten, oude versies en content waarvan niemand weet of die nog gebruikt wordt. Dat is waardevolle informatie. Content die niet meer relevant is, hoeft niet mee naar je volgende systeem. Content die al bestaat, hoef je niet opnieuw te maken. Een simpele inventarisatie levert daarmee productiecapaciteit op nog voordat je iets hebt veranderd.
Stap 2. Geef content een eigen artikelnummer
Vrijwel elk product heeft een uniek identificatienummer, omdat “die-pot-biologische-pindakaas-van-dat-merk” voor een systeem niet nauwkeurig genoeg is. Het systeem moet exact weten waarover we praten.
Bij content werkt dat hetzelfde, en zijn alleen bestandsnamen daarvoor te zwak. Een bestand kan gekopieerd worden, hernoemd worden en op meerdere plekken belanden. Geef belangrijke content daarom een eigen ID, los van de plek waar je hem gebruikt. Zie het als het artikelnummer van je content.
Zo blijf je herkennen dat dezelfde afbeelding op je website, in je app en in een nieuwsbrief nog steeds hetzelfde onderliggende contentobject is. Dat klinkt technisch, maar het principe is eenvoudig: één vaste identiteit maakt versiebeheer, hergebruik en koppelingen met andere systemen ineens betrouwbaar.
Stap 3. Geef content een etiket
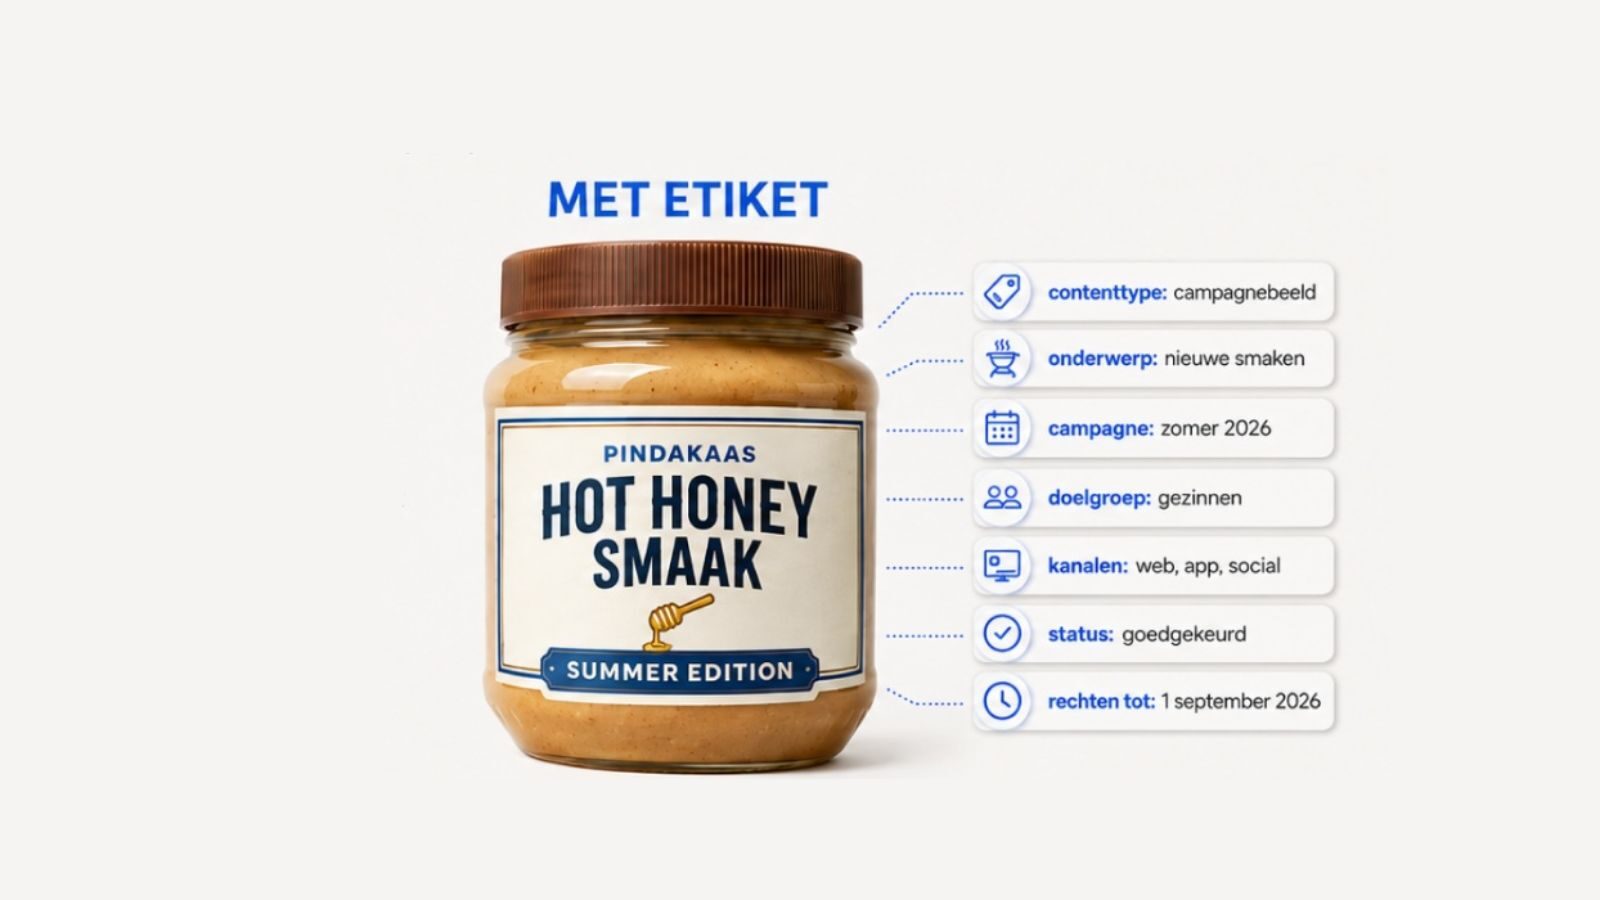
Een product zonder verpakking of etiket is lastig te verkopen. We willen weten wat erin zit. Bij content is dat etiket je metadata: informatie die iets over de content vertelt.
Bij een afbeelding zou je bijvoorbeeld kunnen vastleggen:
- contenttype: productfoto
- product: vegetarische burger
- campagne: zomer 2026
- onderwerp: barbecue
- doelgroep: gezinnen
- taal: Nederlands
- status: goedgekeurd
- gebruiksrechten tot: 1 september 2026
Ineens is die afbeelding niet langer een bestand, maar een asset met context. Daardoor kunnen mensen én systemen het vinden, begrijpen en gebruiken.
Dat laatste wordt steeds belangrijker. Een mens ziet in één oogopslag dat er een barbecue, twee kinderen en een vegetarische burger op staan. Een systeem moet die context ergens vandaan halen. AI herkent tegenwoordig een deel daarvan automatisch, maar weet daarmee nog steeds niet dat deze specifieke foto is goedgekeurd voor campagne X, dat product Y erop staat, dat de rechten volgende maand verlopen en dat marketing hem niet meer mag gebruiken zodra de verpakking verandert. Die betekenis komt uit je organisatie, en die moet je vastleggen.
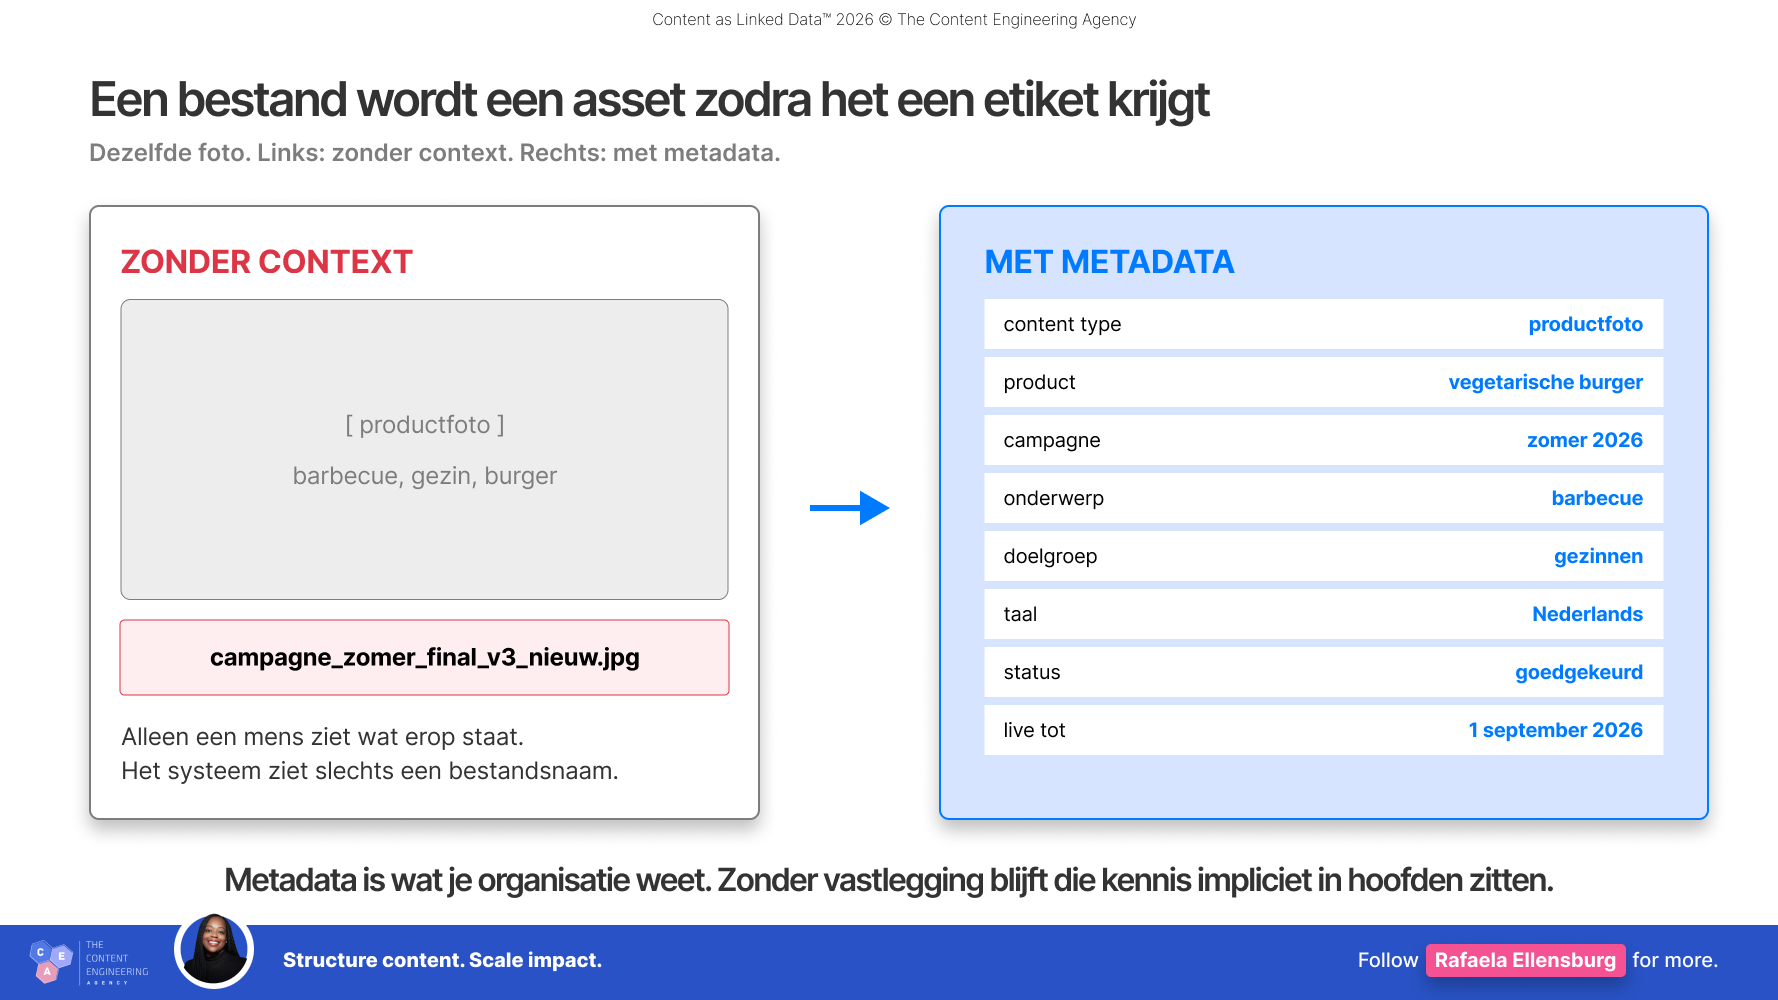
Metadata maakt impliciete kennis over content expliciet en bruikbaar voor mensen én systemen. Beeld: The Content Engineering Agency.
Stap 4. Deel je content in zoals je assortiment
Loop een supermarkt binnen en de pindakaas staat niet willekeurig tussen het wasmiddel en de kattenbakvulling. Producten zijn logisch ingedeeld, met categorieën en classificaties. Met content kun je precies hetzelfde doen, zoals hieronder:
Contenttypes
Bijvoorbeeld:
- artikel
- producttekst
- afbeelding
- video
- handleiding
Onderwerpen
Bijvoorbeeld:
- duurzaamheid
- gezondheid
- wonen
- financiën
Doelgroepen
Bijvoorbeeld:
- consument
- zakelijke klant
- medewerker
Lifecycle
Bijvoorbeeld:
- concept
- goedgekeurd
- gepubliceerd
- verlopen
- gearchiveerd
Zo’n gecontroleerde manier om content te classificeren en categorieën te geven, noemen we vaak een taxonomie. Dat woord klinkt ingewikkelder dan het is: een afgesproken manier om dingen in categorieën te organiseren. Het belangrijkste woord daarin is afgesproken.
Want als marketing spreekt over “zomeractie”, e-commerce over “summer campaign” en het campagnesysteem over “SUM26”, begrijpen mensen misschien nog wel dat het om hetzelfde gaat. Systemen weten dat niet vanzelf. Een gedeelde taal met gedeelde betekenis voorkomt dat elke afdeling zijn eigen digitale werkelijkheid opbouwt.
Stap 5. Beheer ook de houdbaarheid
In een supermarkt controleren we houdbaarheidsdata. Bij content doen we dat zelden. Een blog gaat natuurlijk niet schimmelen, maar over de datum raken kan content prima: oude prijzen, verlopen acties, voormalige medewerkers, veranderde wetgeving, oude verpakkingen in productfoto’s, achterhaalde instructies en verlopen beeldrechten.
Bij elke serieuze contentvoorraad hoort daarom een lifecycle. Wie is eigenaar? Wanneer moet de content opnieuw beoordeeld worden? Wanneer mag die niet meer gebruikt worden? Wat gebeurt er met oude versies?
Dat is content governance, alweer een term die groter klinkt dan nodig. In de praktijk begint governance bij duidelijke afspraken over wie waarvoor verantwoordelijk is. Een magazijn zonder voorraadbeheer verandert op den duur in een rommelige opslagplaats. Een contentplatform zonder governance ook.
En dan pas wordt hergebruik interessant
Zodra je weet wat je hebt, content een identiteit geeft, het expliciet beschrijft en afspraken maakt over categorieën en lifecycle, gebeurt er iets nuttigs: Je hoeft niet meer voor ieder kanaal opnieuw te beginnen.
Stel dat je een product introduceert. Daarvoor heb je een productnaam, een korte en een uitgebreide omschrijving, een prijs, een packshot, eventueel ingrediënten en een campagneboodschap. Traditioneel worden delen daarvan opnieuw overgetypt naar de website, de app, de nieuwsbrief en een social post. Beheer je die informatie als herbruikbare bouwstenen, dan putten al die kanalen uit dezelfde bron.
Prijs aangepast? Dan hoef je niet vijf uitingen op te sporen waarin die prijs ooit handmatig is overgenomen. Je wijzigt de informatie één keer in de bron, waarna die kan doorwerken naar de kanalen waar ze wordt gebruikt. In de wereld van productinformatie is dat een vertrouwd patroon: één betrouwbare bron (Single Source of Truth), van waaruit informatie naar verschillende kanalen wordt verspreid. Voor content kennen we een vergelijkbaar principe als Create Once, Publish Everywhere (COPE): één keer creëren en beheren, vervolgens op meerdere plekken gebruiken.
Voor producten vinden we dit soort principes heel normaal. Voor content kopiëren en plakken we nog steeds alsof ieder kanaal nieuwe content nodig heeft.
Wat AI hiermee te maken heeft
Veel organisaties denken nu na over AI-readiness. Welke modellen gebruiken we, welke chatbot bouwen we, welke tool kan onze content produceren? Onder die vragen ligt een fundamentelere: kan AI eigenlijk zien welke content van ons betrouwbaar, actueel en relevant is?
Als er vijf versies van dezelfde tekst rondzwerven, welke moet een AI-assistent dan gebruiken? Als nergens is vastgelegd wie eigenaar is, hoe bepaalt AI welke bron leidend is? Als content niet gekoppeld is aan producten, campagnes en onderwerpen, hoeveel context moet AI dan telkens opnieuw reconstrueren?
AI verandert het basisprincipe niet. Het maakt goed voorraadbeheer belangrijker. Je kunt een hypermoderne robot in je magazijn zetten, maar zonder labels, met willekeurig gevulde schappen en zonder zicht op wat nog verkocht mag worden, wordt die robot vooral heel efficiënt in het verschuiven van chaos.
Begin bij één contenttype
Dit klinkt misschien als een transformatieprogramma van jaren. Dat hoeft het niet te zijn. Begin bij één contenttype waarvan iedereen weet dat het gedoe oplevert, bijvoorbeeld je productafbeeldingen, en stel vijf vragen:
- Wat hebben we?
- Hoe herkennen we ieder uniek item?
- Welke informatie moeten we erover weten?
- Hoe delen we het logisch in?
- Wie beheert het en wanneer is het verouderd?
Doe dat goed voor dat ene type en breid daarna uit. Zo bouw je stap voor stap een beheersbare contentvoorraad.
Van content produceren naar content laten werken
We zijn jarenlang steeds beter geworden in content maken. Nu moeten we beter worden in content beheren. Schaalbaarheid ontstaat namelijk niet doordat je sneller nieuwe content produceert, maar doordat bestaande content vaker waarde levert zonder dat mensen telkens hetzelfde werk opnieuw doen.
Dat vergt andere vragen. Naast “wat moeten we nog maken?” ook “wat hebben we eigenlijk al?”. Naast “in welk systeem zetten we dit?” ook “wat is dit, wat betekent het en hoe moet het gebruikt worden?”. En naast “kan AI hier content van maken?” ook “hebben wij onze content zo georganiseerd dat AI begrijpt waar het mee werkt en er telkens betrouwbare output mee kan genereren”.
We vinden het volstrekt normaal om producten te identificeren, categoriseren, beschrijven, beheren en distribueren. Met content zouden we precies hetzelfde moeten doen.
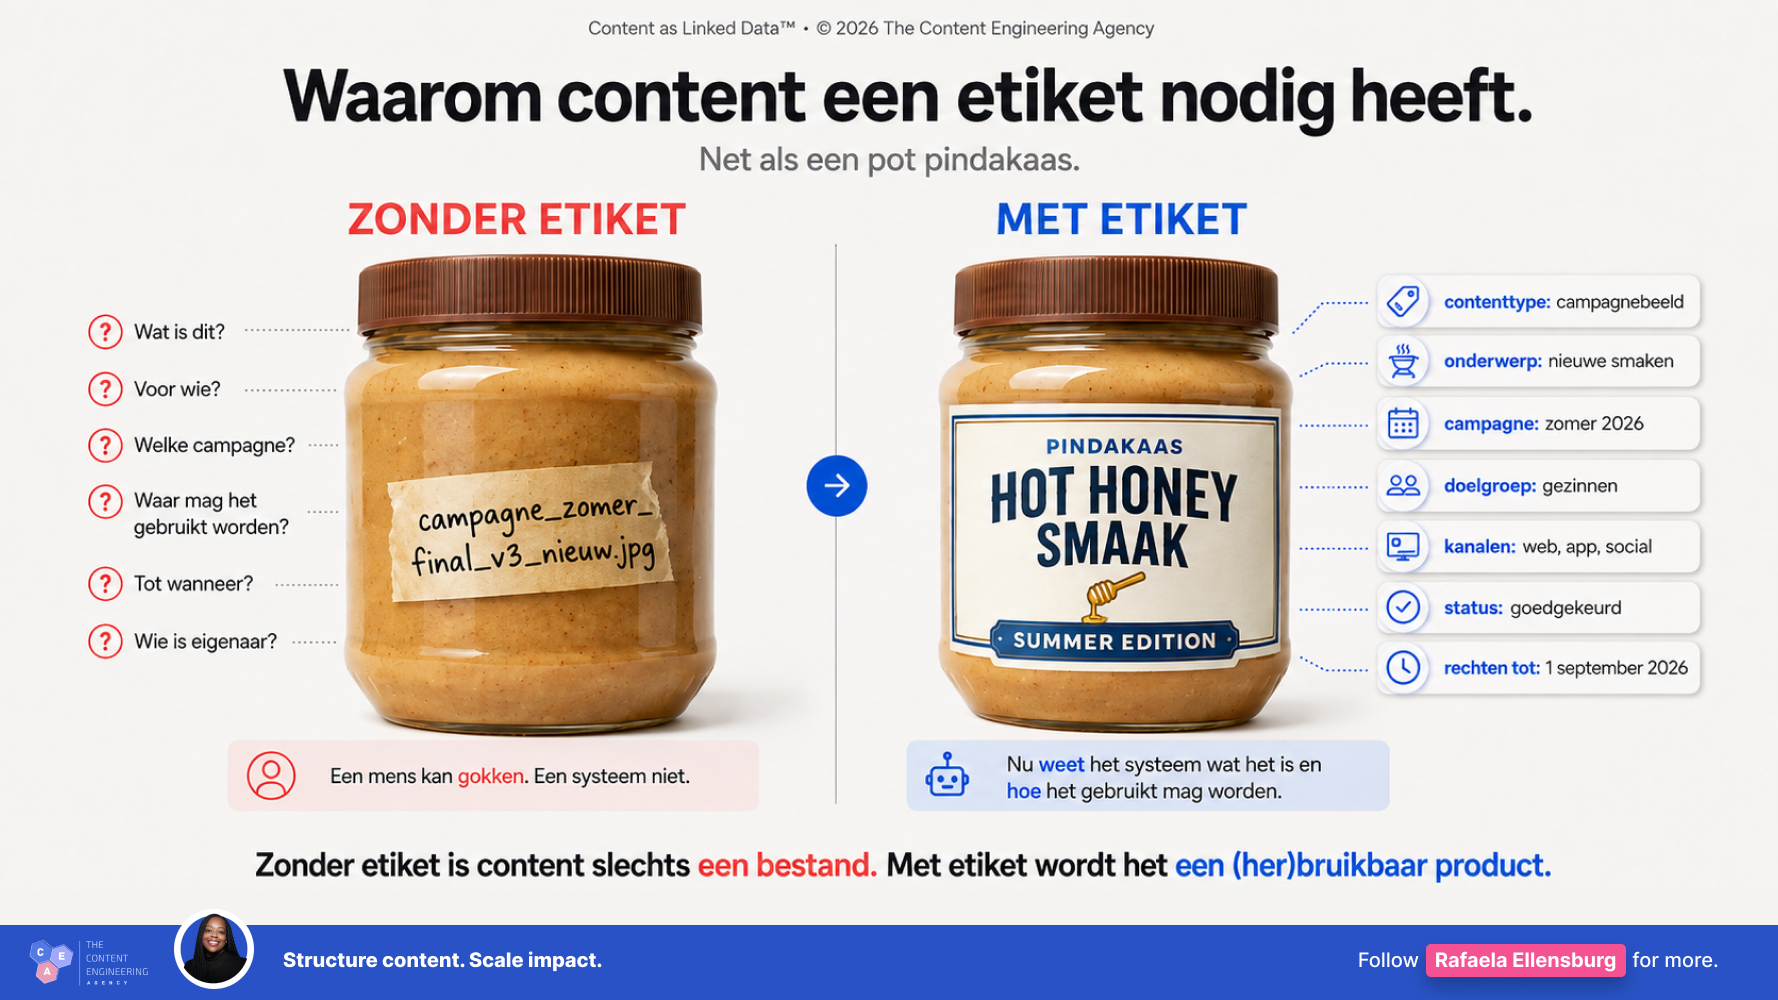
Behandel content zoals een product: geef het een identiteit, context en gebruiksvoorwaarden, zodat mensen én systemen weten wat het is en hoe het gebruikt mag worden. Beeld: The Content Engineering Agency.
Content is geen pak yoghurt en geen pot pindakaas. Maar zodra je duizenden stukken content over meerdere mensen, systemen en kanalen moet beheren, gelden opvallend veel van dezelfde principes. Behandel je content daarom net zo serieus als je producten. Je hoeft dan niet harder te produceren. Je laat de voorraad die je al hebt harder voor je werken.

Bekijk de korte video's