
Watermeloen in je wijn: 5 contentlessen uit mislukte AI-afbeeldingen van Just Eat

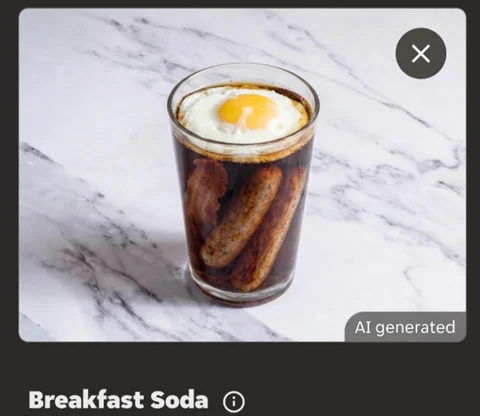
Een gebakken ei dat in een glas cola drijft. Kaas verpakt als sushi. Knoflookbrood in de vorm van een vliegtuig. Stukken watermeloen in een glas Sauvignon Blanc. Het klinkt als een slechte koortsdroom van een foodstylist. Toch zijn het precies het soort fouten dat ontstaat wanneer generatieve AI alleen woorden krijgt, maar niet de betekenis die bij die woorden hoort.
Just Eat experimenteerde met AI-gegenereerde afbeeldingen voor menu-items van kleinere horecazaken. De trial werd volgens The Grocer gepauzeerd nadat verschillende beelden de menutekst wel heel letterlijk hadden geïnterpreteerd.
Grappig? Zeker. Maar achter die mislukte afbeeldingen zit een veel interessantere vraag: hoeveel van de betekenis in onze content bestaat alleen in het hoofd van mensen?
AI kan pas betrouwbaar werken met betekenis die we expliciet genoeg hebben gemaakt om mee te geven.
Mensen lezen nooit alleen de woorden
Neem een menu-item als Breakfast Soda. Voor iemand in Noord-Ierland kan dat volkomen logisch zijn. ‘Soda’ kan daar verwijzen naar ‘soda bread’. Een Breakfast Soda is dus geen frisdrank als ontbijt, maar een broodje met ontbijtbeleg.
Een AI-model dat alleen die twee woorden krijgt, ziet iets anders. Breakfast. Soda. Het resultaat: een glas frisdrank met ontbijt erin.
Wat het model mist, neemt een lokale klant automatisch mee. We begrijpen een woord niet alleen door de letters die er staan. We kijken waar het op de pagina staat, in welke categorie het voorkomt, welke producten ernaast staan en welke taal en cultuur erbij horen. We herkennen bovendien vrij snel wat in die context absurd zou zijn.
Die kennis staat zelden in de content zelf. Afkortingen waarvan iedereen intern weet wat ze betekenen. Productnamen die alleen logisch zijn binnen één categorie. Labels die per land anders uitpakken. Veel content vertelt nooit expliciet wat iets is, omdat de lezer dat toch wel begrijpt. Totdat die lezer geen mens meer is.
Dat verandert wat we onder ‘goede content’ moeten verstaan. Content moet nog steeds leesbaar en bruikbaar zijn voor mensen, maar de betekenis moet óók expliciet genoeg zijn om tussen systemen, modellen en kanalen te reizen. Daar komt content engineering in beeld: vóór gebruik vastleggen wat iets is, wat het betekent, hoe het samenhangt en onder welke voorwaarden een systeem ermee mag werken.
De vijf mislukte menubeelden laten verrassend goed zien hoe dat eruitziet.
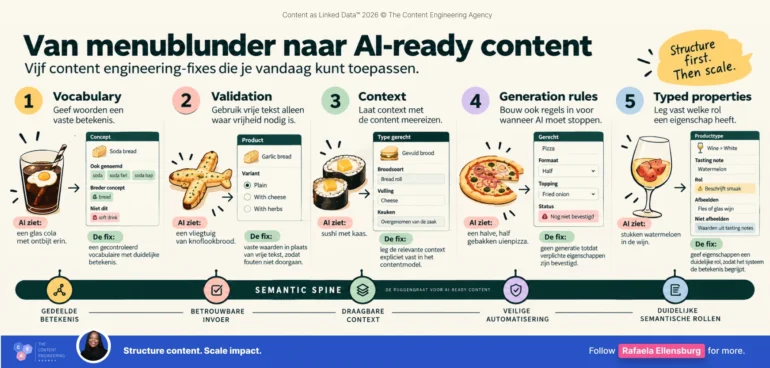
1. Geef woorden een vaste betekenis
Terug naar Breakfast Soda. Je zou het kunnen oplossen met een betere prompt: “Let op, soda betekent hier misschien soda bread.” Daarmee repareer je deze ene generatie, niet het onderliggende probleem.
Duurzamer is een gecontroleerd vocabulaire. Dat klinkt technischer dan het is. Je spreekt af welke concepten bestaan, welke woorden mensen ervoor gebruiken en welke betekenis een term binnen een context heeft.
concept: soda bread
ook genoemd: soda, soda farl, soda bap
breder concept: bread
betekent hier niet: soft drink
De lokale naam blijft gewoon op het menu staan. Je hoeft menselijke taal niet plat te slaan tot robottaal. Je maakt alleen expliciet waar die taal naar verwijst.
De Content Engineering-fix
Kijk in je eigen organisatie naar woorden die mensen prima begrijpen, maar die voor een systeem dubbelzinnig zijn: productcategorieën, interne afkortingen, regionale termen, vakjargon. Leg niet alleen een lijst met voorkeurswoorden aan, maar ook welk concept achter het woord zit, welke synoniemen er zijn en welke termen niet verward mogen worden. Koppel je CMS, PIM of DAM waar mogelijk aan die afgesproken waarden. Dan verschuift de vraag van ‘Welke woorden staan hier?’ naar ‘Welk concept bedoelen we hiermee?’
2. Gebruik vrije tekst alleen waar vrijheid nodig is
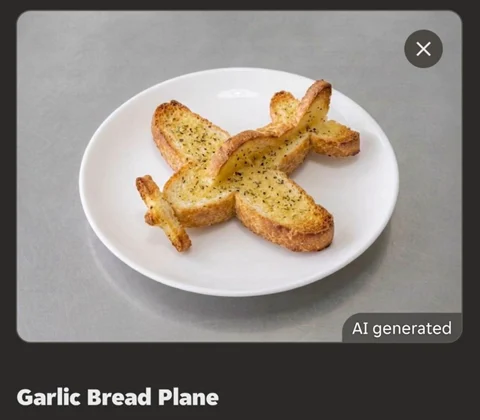
Een ander menu-item luidde Garlic Bread Plane. ‘Plane’ was vrijwel zeker een typefout voor plain. Een mens corrigeert dat tijdens het lezen zonder erbij stil te staan. Het model deed iets anders: ‘plane’ betekent vliegtuig, dus het knoflookbrood kreeg vleugels.
Dit lijkt een promptprobleem, maar het is een datamodelprobleem. Stel dat je niet één vrij tekstveld gebruikt, maar twee eigenschappen:
product: garlic bread
variant: plain | with cheese
Dan is ‘plane’ geen creatieve input meer, maar een waarde die niet in de lijst voorkomt. Het systeem houdt die invoer tegen voordat er een prompt naar het beeldmodel gaat.
De Content Engineering-fix
Loop een belangrijk contentproces door en kijk waar mensen vrije tekst invoeren. Vraag per veld: is hier werkelijk onbeperkte vrijheid nodig? Bij een productomschrijving waarschijnlijk wel. Bij taal, land, producttype, status, formaat of variant meestal niet. Bestaan er drie geldige waarden, leg die drie dan vast. Een keuzelijst voorkomt niet alleen typefouten, maar zorgt er ook voor dat dezelfde betekenis overal op dezelfde manier herkend wordt. Ieder vrij tekstveld geeft AI extra gelegenheid om te gokken.
3. Laat context met de content meereizen
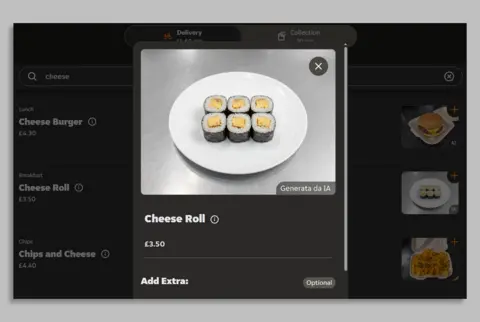
Mijn favoriete voorbeeld is Cheese Roll. De AI maakte er sushi met kaas van. Op zichzelf niet vreemd: een roll kan tenslotte een sushirol zijn.
Een klant van een broodjeszaak zal die interpretatie vrijwel nooit maken. Die leest niet alleen ‘Cheese Roll’, maar ziet de broodjeszaak, het menu, de categorie sandwiches en de producten eromheen. De betekenis ontstaat uit de omgeving. Krijgt de AI alleen die twee woorden, dan hebben we alle context weggegooid en vragen we het model vervolgens om hem terug te raden.
Een getypeerd contentmodel maakt die ontbrekende context expliciet. Je slaat niet alleen een titel op, maar ook de eigenschappen die vertellen wat voor soort ding het is:
type gerecht: gevuld brood
broodsoort: bread roll
vulling: cheese
keuken: overgenomen uit profiel van de zaak
De Content Engineering-fix
Kies één belangrijk contentobject: een product, dienst, FAQ, vacature of beeld. Schrijf op welke informatie een medewerker onbewust gebruikt om dat object goed te begrijpen. Staat die informatie daadwerkelijk bij het object opgeslagen? Of zit een deel in een mapnaam, een CMS-sectie, een teamafspraak of het hoofd van een collega? Maak die context onderdeel van het contentmodel: type, onderwerp, doelgroep, markt, taal, eigenaar. Sommige waarden hoef je niet steeds in te voeren, die kan een item erven van de categorie of het bovenliggende profiel.
Dat is het belangrijkste voordeel van structured content: structuur maakt betekenis draagbaar. Content kan naar een ander kanaal, systeem of AI-agent bewegen zonder onderweg zijn context kwijt te raken.
4. Bouw ook regels in voor wanneer AI moet stoppen
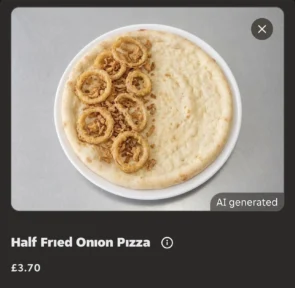
Dan de Half Fried Onion Pizza. Vier woorden, meerdere interpretaties. Wat betekent half? Een halve pizza? Half gebakken? Een halve ui?
De AI moest kiezen, en daar zit het probleem. Niet omdat een model nooit mag redeneren, maar omdat de onderliggende informatie hier onvoldoende is om betrouwbaar verder te gaan. Splits je de informatie op, dan wordt de onzekerheid zichtbaar:
gerecht: pizza
formaat: half
topping: fried onion
status: nog niet bevestigd
Daar koppel je een regel aan: geen afbeelding genereren zolang verplichte eigenschappen niet bevestigd zijn. Zo’n generation gate klinkt weinig spectaculair naast de nieuwste AI-demo, maar betrouwbare automatisering bestaat voor een groot deel uit dit soort grenzen.
De Content Engineering-fix
Bepaal bij een AI-proces niet alleen wat nodig is om generatie mogelijk te maken, maar ook wat minimaal bekend moet zijn om generatie verantwoord te starten. Welke velden zijn verplicht? Welke status moet een item hebben? Wanneer is menselijke controle nodig? Maak daar een expliciete regel van: een afbeelding mag alleen gegenereerd worden wanneer producttype, variant en formaat bevestigd zijn. Een AI-assistent mag een antwoord alleen publiceren wanneer de bronstatus ‘goedgekeurd’ is.
We besteden veel aandacht aan wat AI autonoom moet kunnen. Een volwassen AI-systeem weet ook wanneer het moet stoppen. Een leeg afbeeldingsvak is soms goedkoper dan een fout beeld dat automatisch op honderden plekken verschijnt.
5. Leg vast welke rol een eigenschap heeft
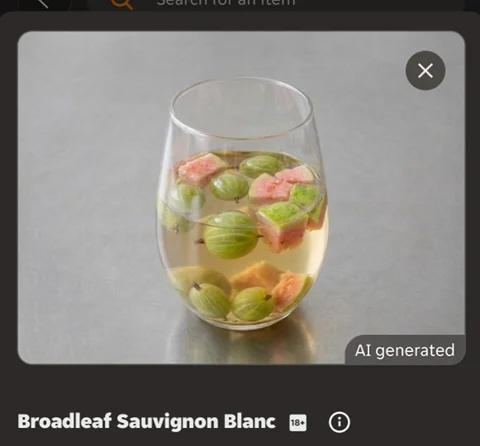
Het laatste voorbeeld komt uit een wijnbeschrijving. Een Sauvignon Blanc had smaaknotities van watermeloen. De gegenereerde afbeelding bevatte daadwerkelijk stukken watermeloen in het glas.
Voor een mens is het verschil vanzelfsprekend. ‘Watermelon’ als tasting note is iets anders dan ‘watermelon’ als ingredient. Voor een systeem dat één grote beschrijving ontvangt, is ‘watermelon’ vooral een woord. Pas wanneer je het veld en de betekenis van dat veld meegeeft, ontstaat de semantische rol:
producttype: wine > white
tasting note: watermelon
rol: describes flavour
afbeelden: fles of glas wijn
niet afbeelden: waarden uit tasting notes
Het woord ‘watermelon’ verandert niet. De betekenis wordt bepaald door de eigenschap waarin het staat. Dat principe zie je overal. ‘Verplicht’ bij een vacature is iets anders dan ‘pré’. Een symptoom is iets anders dan een diagnose. Een marketingclaim is iets anders dan een geverifieerde productspecificatie. Leg je die verschillen niet vast, dan vraag je AI om ze iedere keer opnieuw af te leiden. Soms gaat dat goed. Soms krijg je watermeloen in je wijn.
De Content Engineering-fix
Kijk naar de velden waarin nu meerdere soorten informatie door elkaar staan. Een groot veld ‘omschrijving’ is meestal een goede plek om te beginnen. Kun je onderdelen daarvan een expliciete rol geven: ingrediënt, smaak, voordeel, waarschuwing, specificatie, claim? Daar kun je vervolgens regels aan verbinden. Een ingrediënt mag terugkomen op een productafbeelding, een smaakassociatie niet. Een goedgekeurde specificatie mag in een antwoord, een marketingclaim misschien alleen binnen een bepaalde context.
De betekenislaag onder je data
Bij veel AI-projecten gaat de aandacht naar datakwaliteit. Is de data correct, compleet, actueel en consistent? Allemaal noodzakelijk. Voor generatieve en agentic AI komt daar een andere categorie vragen naast. Weet het systeem wat voor soort object dit is? Welke betekenis heeft een term in deze context? Welke waarden zijn toegestaan? Wat is beschrijvend en wat is samenstellend? Wanneer ontbreekt er te veel om veilig verder te gaan?
Die structuur noem ik de Semantic Spine: de semantische ruggengraat waardoor betekenis overeind blijft wanneer content tussen mensen, systemen en AI beweegt. Ontbreekt die ruggengraat, dan ontstaat Meaning Debt.
Het is verleidelijk om naar die mislukte afbeeldingen te kijken en te zeggen: kijk eens hoe dom AI nog is. Maar het model legt vooral bloot hoeveel betekenis nooit in de systemen zelf terechtkwam. De lokale klant wist wat ‘soda’ betekende. De medewerker wist dat ‘plane’ een typefout was. De bezoeker wist dat een ‘cheese roll’ brood was. De restauranthouder wist wat ‘half’ betekende. De wijnliefhebber wist dat watermeloen een smaaknotitie was.
Daar zit de Meaning Debt: betekenis die nodig is om een proces betrouwbaar uit te voeren, maar nergens is vastgelegd. Zolang mensen het werk doen, blijft die schuld jarenlang onopgemerkt. Zodra je wilt automatiseren, personaliseren of agents zelfstandig laat handelen, wordt de rekening zichtbaar. AI creëert die gaten niet. AI maakt zichtbaar waar mensen ze jarenlang ongemerkt hebben dichtgelopen.
Hoe voorkom je dit in je eigen organisatie?
Je hoeft niet meteen je complete contentlandschap opnieuw te modelleren. In mijn eerdere artikel over content als een pot pindakaas schreef ik al: begin bij één herkenbaar en strategisch waardevol contenttype. Hier geldt hetzelfde.
Kies één producttype, FAQ-set, kennisbank of collectie afbeeldingen die je met AI wilt gebruiken, en bekijk vijf dingen:
- Vocabulary: gebruiken mensen verschillende woorden voor hetzelfde concept, of één woord voor verschillende dingen?
- Validation: welke eigenschappen kunnen beter uit vaste waarden bestaan dan uit vrije tekst?
- Context: welke kennis gebruikt een mens om de content te begrijpen die nu niet bij het object staat?
- Generation rules: welke informatie moet bevestigd zijn voordat AI iets mag genereren of publiceren?
- Typed properties: welke woorden krijgen pas hun juiste betekenis doordat duidelijk is welk soort eigenschap ze beschrijven?
Daar heb je geen nieuw platform voor nodig. Zet één contentobject op tafel en vergelijk wat een medewerker ervan weet met wat het systeem ervan weet. Het verschil daartussen is je eerste kaart van de Meaning Debt.
 De belangrijkste AI-vraag komt vóór de prompt
Die vraag is niet wat we met AI kunnen genereren, maar wat ons systeem eigenlijk weet voordat de generatie begint. Weet het dat ‘soda’ hier brood betekent? Dat ‘plane’ niet is toegestaan? Dat ‘half’ eerst bevestigd moet worden? Dat watermeloen een smaakeigenschap is en geen ingrediënt?
Een beter model kan veel. Een betere prompt ook. Maar geen van beide verandert je vrije tekstvelden in gecontroleerde waarden, legt impliciete bedrijfskennis vast of bepaalt wanneer een workflow moet stoppen. Daar heb je structuur voor nodig. AI heeft niet alleen meer content nodig. Het heeft content nodig met een ruggengraat van expliciete betekenis.
Bekijk de korte video's




Canva met AI
Meer wetenData & AI voor Marketing
Meer wetenEen overzichtelijke contentkalender maak je zo [7 tools]
Meer wetenZo zorg je dat kijkers niet wegscrollen bij je YouTube Shorts
Meer wetenContent & AI
Meer weten8 strategische tips om slimmer te werken met Copilot
Meer wetenNapkin AI: de tool die jouw tekst omzet naar ijzersterke visuals
Meer wetenDeze nieuwe YouTube-functies zijn interessant voor zichtbaarheid & groei
Meer wetenCanva met AI
Meer wetenDe nieuwe SEO- & GEO-spelregels: scoren in Google én AI-search
Meer wetenOp zoek naar nog meer kennis?
-
Nieuw jaarplan, zelfde knelpunten. Zo kom je erachter wat er echt speelt
-
Zo claim je jouw bedrijf in ChatGPT met Business Hub [how to]
-
Nieuwe OpenAI-functie: is ChatGPT Business Hub de doodsteek voor AI-visibility trackers?
-
Nieuwe TikTok Symphony update: dit moet je weten
-
AI-zichtbaarheid krijg je buiten je eigen website: lessen uit 20.000 AI-antwoorden